Slik brukte vi maskinlæring til å finne bygninger i Bergen
Vi trente en modell på offentlig tilgjengelig punktskydata fra Bergen – og identifiserte bygninger med 98 prosent treffsikkerhet.
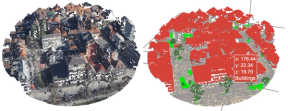
Visste du at hele Norge er laserskannet fra fly? Et fly med laserskanner sender pulser mot bakken og måler tiden det tar før pulsen kommer tilbake. Teknikken heter ALS (Airborne Laser Scanning), og resultatet er en såkalt punktsky: milliarder av 3D-punkter, med litt metadata om hvert punkt. Mye av dataen fra det nasjonale overflyvningsprosjektet er tilgjengelig for allmennheten på hoydedata.no.
Ofte ønsker man å klassifisere punktene i en punktsky, det vil si at man markerer hvert punkt med en klasse som forteller hva det representerer. Slik kan man gjøre analyser av for eksempel vegetasjon, infrastruktur eller vann innenfor et område. Noe av klassifiseringen løses i dag med regelbaserte verktøy med høy treffsikkerhet. For eksempel finnes det effektive metoder for å klassifisere hvilke punkter som representerer bakken. De øvrige klassene, deriblant bygninger, er vanskeligere å klassifisere, og innebærer ofte tidkrevende manuelt arbeid. Store deler av det nasjonale datasettet er derfor ikke klassifisert utover de enkleste klassene. Vi ønsket å undersøke om en maskinlæringsmodell kunne gjøre klassifisering av bygninger automatisk.

Vi introduserer Superpoint Transformer
Et enkelt punkt gir lite informasjon alene. En måling fire meter over bakken kan være et tak, et brodekke eller en trekrone. Det som skiller dem, er omgivelsene. Akkurat som et ord først gir mening i kontekst.
Modellarkitekturen Superpoint Transformer, publisert av Robert, Raguet og Landrieu i 2023, løser dette effektivt. I stedet for å behandle hvert punkt for seg, grupperes punktene i geometrisk like segmenter kalt superpoints. Et flatt takstykke blir ett segment, en vegg et annet, greinene på et tre noen andre. Modellen vurderer så hvert segment i lys av segmentene rundt det, og punktene arver klassen til segmentet de tilhører. Det er dette som gjør at en modell kan trenes effektivt på milliarder av punkter.
Også relevant til vårt prosjekt er en masteroppgave fra NTNU, skrevet av Lars Flem og Jakob Punnerud i samarbeid med Kartverket. De testet Superpoint Transformer på utvalgte områder i Norge og fikk lovende resultater. På flatt og moderat terreng var resultatene gode, men i kupert terreng som Bergen falt resultatene vesentlig. Både Lars og Jakob begynte for øvrig i Bekk i august.
Hvorfor Bergen
Et datasett er bare brukbart til trening av modellen vår hvis det inneholder en fasit på hva som er bygning. Det aller meste som er nedlastbart fra hoydedata.no har kun klasser for bakke, bru og vann, mens de øvrige punktene er uklassifisert. Bergen er en av de få nedlastbare datasettene som faktisk har bygningene ferdig klassifisert.
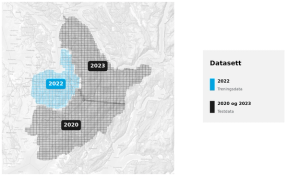
I tillegg byr terrenget på alt fra tett bysentrum til bratte fjellsider, nettopp den variasjonen Lars og Jakob pekte på som årsak til at modellen sviktet. Punktskydekningen er dessuten svært god, med over 13 milliarder punkter fordelt på tre uavhengige datasett fra ulike år:

Tilpasninger av modellen
For å tilpasse modellen til norske forhold gjorde vi to viktige utvidelser på Superpoint Transformer:
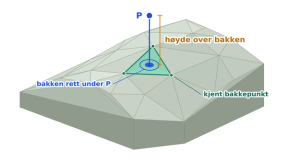
- Mer presis beregning av høyde over bakken. En nøkkelvariabel i klassifisering av bygning er et gitt punkts høyde over bakken. Denne variabelen kan estimeres basert på ferdig klassifiserte bakkepunkter. Masteroppgaven estimerte bakken med en grov approksimasjon: et rutenett med store lineære plan som følger terrenget sånn omtrentlig. I flatt terreng er det en god nok tilnærming. I Bergen, der terrenget er mer kupert, blir høyden systematisk feil.
Vi erstattet den grove bakkemodellen med små trekanter mellom kjente bakkepunkter. For å finne avstanden til bakken under et punkt, finner vi trekanten punktet ligger over og leser av høyden der – en teknikk kalt Delaunay-triangulering, illustrert i figuren under. Metoden gir høyde over bakken-variabler som er vesentlig mer nøyaktig.

- Bedre utnyttelse av metadata for hvert punkt. Under datainnsamlingen sendes laserpulsen ned og reflekteres tilbake til flyet. En puls som treffer et tak, gir oftest bare én returpuls. En puls som går gjennom et tre kan i midlertid gi flere: én fra de øverste greinene, kanskje én fra midten, og én fra bakken under. Hvert punkt i punktskyen har metadata om antall returer for den gjeldende laserpulsen og hvilket nummer i rekka over returer dette punktet representerer. Verken den opprinnelige implementasjonen av Superpoint Transformer eller masteroppgaven brukte denne metadaten. Vi la inn både antall returer og hvor i rekken punktet ligger.
Hvordan måler vi modellens ytelse?
Vi bruker hovedsaklig to mål for å si noe om modellens ytelse:
- Av det totale antallet faktiske bygningspunkter, hvor mange klarte modellen å finne? Dette kalles recall.
- Blant de punktene modellen klassifiserte som bygning, hvor mange var faktisk bygning? Dette kalles precision.
Begge målene er viktige. Et bygningspunkt modellen overser, er like problematisk som et vegetasjonspunkt den feilaktig kaller bygning. Kartverkets produktspesifikasjon for punktsky sier at maksimalt 2 prosent av punktene i et område kan være feilklassifisert – noe som i praksis betyr at recall må ligge på minst 98 prosent.
Resultater på bygninger
For å vurdere modellens ytelse testet vi den på data den ikke hadde sett under opplæringen – i vårt tilfelle datasettene Bergen 2020 og Bergen 2023. Figuren under viser precision og recall for begge datasettene.

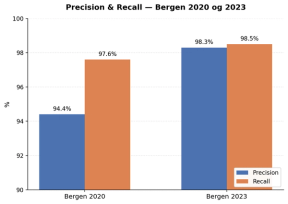
Resultatene for Bergen 2023-datasettet er svært lovende, med over 98% på både precision og recall. Modellen finner nesten alle bygninger. Dette indikerer at vi er nærme å kunne tilfredsstille produktspesifikasjonen for punktsky om maksimalt 2% feilklassifisering. Bergen 2020-datasettet er også i nærheten av 98% på recall, mens precision ligger noe lavere. En grunn til forskjellen i precision kan være at 2023-datasettet har en høyere andel uklassifiserte punkter, og for disse punktene kan ikke prediksjonene valideres mot en fasit. Dette kan være årsak til en kunstig høy precision i dette datasettet.
Videre arbeid er nødvendig for å forbedre ytelsen ytterligere, og verifisere robusthet i geografiske områder med andre karakteristikker.
Veien videre – fra Bergen til hele Norge
Resultatene viser at den tilpassede modellen fungerer godt til å identifisere bygninger i det krevende terrenget rundt Bergen. Vi håper den tilpassede modellen etterhvert kan anvendes til ulike formål på et nasjonalt datasett. Kanskje kan modellen inngå i verktøy for å identifisere ulovlig bebyggelse? Eller beregne presise metrikker for vegetasjon og infrastruktur på nasjonalt plan? For å kunne generalisere modellen til resten av landet ser vi fire konkrete steg:
Testing på andre områder. Se om modellen generaliserer til annen geografi og andre terrengtyper.
Innføre konfidensterskel. Vi setter i dag en klasse på hvert eneste punkt. Med en konfidensterskel kan tvilsomme punkter forbli uklassifisert i stedet for å bli feilmerket. Det løfter precision, som er det svakeste målet i dag.
Justere modelloppsettet. Vi har kjørt ett oppsett, mest sannsynlig finnes det bedre. Den mest lovende justeringen er hvor store segmentene punktene deles inn i bør være.
Bruke fargedata. Farger (RGB) kan gjøre det lettere å skille bygninger fra vegetasjon. Ikke alle datasett har farger, men der de finnes, er det verdt å teste.